
Checklist des données pour les flux de travail d'automatisation pour les équipes Ops
Une liste de contrôle pratique pour auditer, préparer et sécuriser les données des flux de travail d'automatisation avant de déployer des processus intelligents dans votre pile.

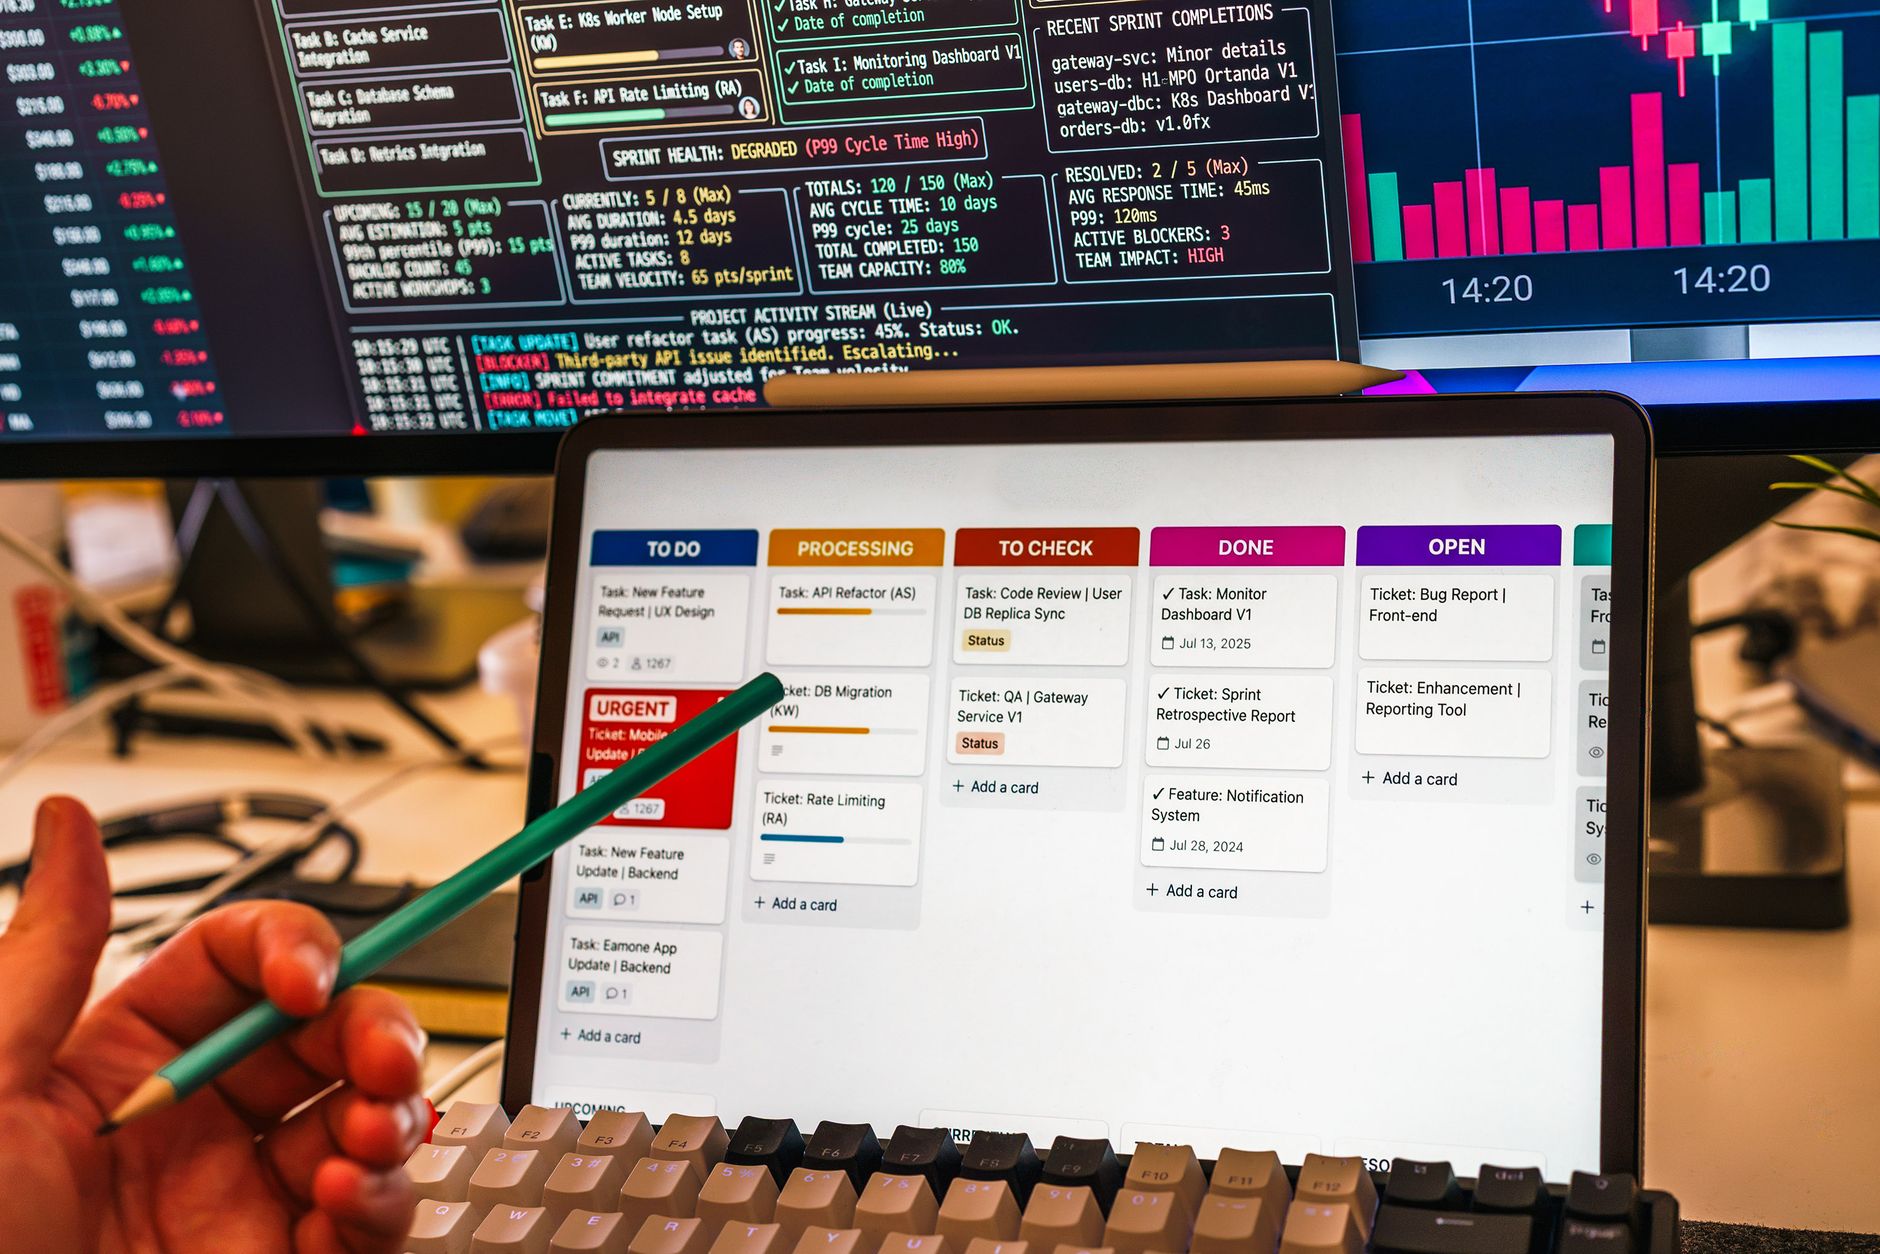
Une liste de contrôle pratique pour auditer, préparer et sécuriser les données des flux de travail d'automatisation avant de déployer des processus intelligents dans votre pile.
Vous connaissez ce signe. Un processus fonctionne en démonstration et échoue en production. Pas parce que la logique était fausse, mais parce que les données sous-jacentes étaient incomplètes, incohérentes ou non fiables. Cette checklist existe pour les équipes opérationnelles qui refusent de mettre en production une autre automatisation qui plante sur les données réelles.
Nous l’avons rédigée pendant des déploiement après déploiement où le goulot d’étranglement n’était jamais l’outil, mais les données qui lui étaient fournies. Si vous vous lancez dans un projet d’automatisation intelligente, passez par cette checklist avant de connecter le premier agent.
Vous pouvez valider la préparation des données seul, puis passer à la cartographie des processus, ensuite au choix du modèle.
Réponse rapide
- Identifiez un processus à haut volume et sujet aux erreurs comme pilote.
- Cartographiez toutes les sources de données que l’automatisation touchera.
- Validez l’exhaustivité, le format et la propriété de chaque source.
- Définissez des indicateurs de réussite liés aux résultats des données, et non seulement à la vitesse.
- Effectuez un test sur un échantillon de 100 enregistrements avant de passer à l’échelle.
Phase pilote : Choisir le bon processus
Commencez petit, mais choisissez un réel problème opérationnel, pas une efficacité théorique.
- Sélectionnez un processus à haute fréquence et actuellement manuel ou sujet aux erreurs.
- Measurez le volume actuel et le temps moyen de traitement par transaction.
- Estimez le coût des échecs du processus actuel en minutes ou en dollars par mois.
- Confirmez la propriété des parties prenantes pour le processus et ses sources de données.
- Définissez les conditions de retour arrière afin qu’un échec ne bloque pas l’activité.
Pourquoi c’est important : Les équipes qui sautent l’étape de confirmation de propriété passent 3 fois plus de temps sur les correctifs ultérieurs, lorsque la responsabilité des erreurs de données est floue.
Points de contrôle critiques
| Élément | Statut |
|---|---|
| Propriétaire du processus identifié | |
| Volume mesuré sur les 30 derniers jours | |
| Coût des échecs estimé | |
| Plan de secours documenté |
Audit des données : Cartographier vos sources
L’automatisation n’est aussi fiable que les données qu’elle ingère. Avant de brancher la logique, tracez chaque entrée et sortie.
- Cataloguez tous les systèmes que l’automatisation lira ou écrira.
- Identifiez l’entité de données principale (client, facture, ticket, etc.).
- Cartographiez les transformations au niveau des champs entre la source et la cible.
- Vérifiez la fréquence des actualisations des données pour chaque système connecté.
- Listez les identifiants d’accès et les limites de débit pour chaque intégration.
Pourquoi c’est important : Un seul champ manquant ou une synchronisation différée peut se manifester comme un échec silencieux de l’automatisation en aval.
Modèle d’inventaire des sources
| Système source | Entité | Fréquence de synchronisation | Propriétaire |
|---|---|---|---|
Qualité des données : Nettoyer avant l’exécution
- Scannez les valeurs nulles et les champs vides dans les colonnes critiques.
- Normalisez les formats pour les dates, les noms et les identifiants.
- Supprimez ou marquez les doublons qui provoquent un traitement en double.
- Validez l’intégrité référentielle entre les systèmes liés.
- Établissez des seuils de qualité des données pour le contrôle préalable à l’exécution.
Pourquoi c’est important : Les mauvaises données produisent des suggestions crédibles mais erronées avec l’automatisation assistée par IA, réduisant la confiance plus rapidement que n’importe quel problème de performance.
Seuils de qualité
| Champ | Taux maximal de valeurs nulles | Format attendu | Action en cas d’échec |
|---|---|---|---|
Gouvernance : Propriété et contrôle d’accès
L’automatisation fait grandir la confiance. Si la gouvernance prend du retard, l’adoption suit le même cap.
- Nommez un gestionnaire de données pour chaque jeu de données automatisé.
- Revoyez les journaux d’accès chaque semaine pendant le déploiement initial.
- Mettez sous contrôle de version la logique d’automatisation et les mappages de données.
- Vérifiez la conformité réglementaire (RGPD, SOX, etc.).
- Planifiez des revues mensuelles de la qualité des données avec les parties prenantes métier.
Pourquoi c’est important : La plupart des dérives d’automatisation ne viennent pas de la dégradation de la logique, mais des évolutions non surveillées des autorisations et des schémas.
Boucle de test : Valider avec des données réelles
- Effectuez un test sur un échantillon de 100 enregistrements via le flux d’automatisation complet.
- Comparez les sorties aux résultats humains connus comme bons.
- Testez les cas extrêmes comme les lignes malformées ou les charges vides.
- Measurez la latence et le taux d’erreurs de chaque étape d’intégration.
- Collectez les commentaires des propriétaires de processus sur l’ergonomie et la précision.
Pourquoi c’est important : Les performances dans le monde réel diffèrent souvent de celles des démos idéalisées, surtout lorsque la qualité des données est variable.
Phase d’extension : Du modèle au système
- Augmentez progressivement la taille des lots tout en surveillant les performances.
- Introduisez un acbasage des exceptions pour les enregistrements qui échouent aux contrôles de qualité.
- Automatisez les alertes en cas d’indisponibilité des sources de données ou de dérive du schéma.
- Surveillez la dérive conceptuelle dans les étapes de classification basées sur l’IA.
- Former les équipes en aval aux nouvelles dépendances et attentes des données.
Points clés à retenir
- Choisissez un processus avec un coût d’échec mesurable, pas seulement un volume élevé.
- La qualité des données est un prérequis, pas une tâche accessoire.
- La gouvernance évite la dérive de l’automatisation après le lancement.
- Testez tôt et souvent avec des données réelles.
- Étendez progressivement, pas en sauts.
Conclusion
Cette checklist aide les équipes opérationnelles à aller plus vite sans compromettre l’intégrité des données ou la gouvernance. Pour les équipes souhaitant appliquer ces pratiques à une gouvernance d’automatisation plus large ou à l’ingénierie de invites pour les agents internes, découvrez Copy&Prompt pour des outils d’invite intégrés aux flux de travail et des bibliothèques partagées.
Questions fréquentes
Que faire si mes sources de données ne peuvent pas être modifiées ?
Appliquez des portes de qualité des données à l’ingestion plutôt que de compter sur des correctifs en amont. Utilisez des couches d’organisation ou des tables d’ombre pour normaliser les données avant que l’automatisation ne les touche.
À quelle fréquence faut-il répéter cette checklist ?
Effectuez l’audit complet une fois par an, ou chaque fois qu’une migration majeure du système a lieu. Les sections sur la qualité des données et la gouvernance doivent être revues chaque trimètre.
Améliorez vos résultats IA dès aujourd’hui - Créez de meilleures invites et obtenez des réponses plus précises avec Copy&Prompt. Copy&Prompt →
Basé sur les pratiques courantes en matière de gouvernance des données pour l’automatisation intelligente et d’optimisation des processus. Les cadres de référence incluent des principes du guide d’automatisation des flux de travail IA de Kognitos, du référentiel sur l’automatisation des flux de travail intelligents de McKinsey, et les cadres opérationnels utilisés dans les déploiements d’automatisation en entreprise.

