
Diseñando agentes de IA y flujos de automatización
Cómo diseñar agentes de IA de calidad de producción, flujos de automatización e integraciones con LLM para sistemas fiables y auditables.

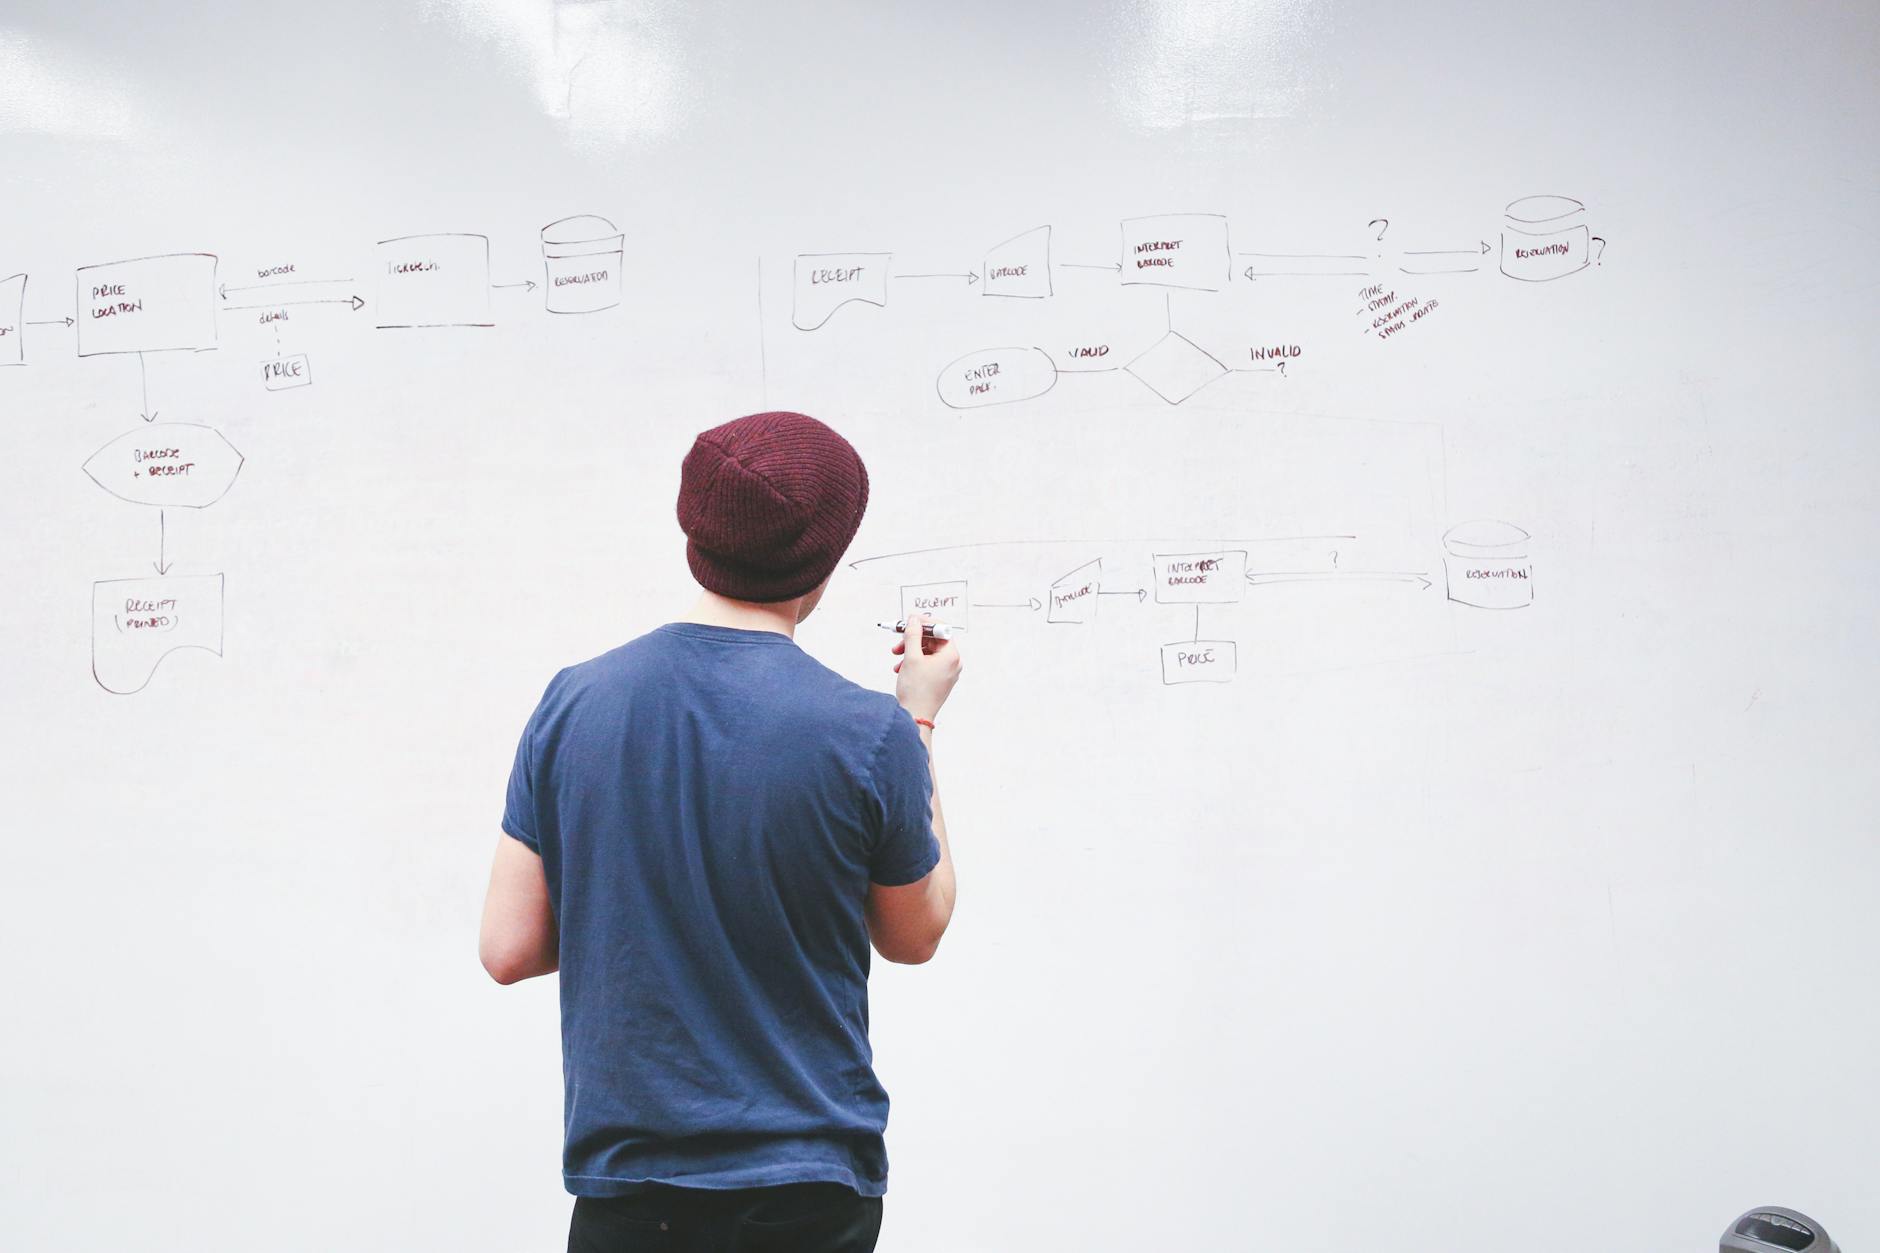
Cómo diseñar agentes de IA de calidad de producción, flujos de automatización e integraciones con LLM para sistemas fiables y auditables.
Copy&Prompt TEAM · Publicado agosto de 2026 · Actualizado agosto de 2026
Tres meses después de una beta, una startup de logística descubrió que su “agente de triaje de facturas” funcionaba en la oficina pero fallaba a escala: errores intermitentes de la API, indicaciones divergentes y estado oculto hacían la automatización frágil. Reconstruimos el agente como un flujo de trabajo determinista con estado explícito, esquema y reintentos. El resultado: el rendimiento aumentó y los incidentes disminuyeron.
Respuesta breve:
Diseña agentes de IA separando rol, contexto, tarea y estado; aplica salidas estructuradas (esquema JSON) y envuelve las llamadas al LLM dentro de primitivas de workflow (reintento, idempotencia, observabilidad). Usa plataformas de integración (n8n, orquestadores personalizados) para conectores y una biblioteca de prompts para versionado.
Contenido
- ¿Qué falla en los agentes de IA y la automatización?
- Marco: rol→contexto→tarea→estado
- Indicaciones paso a paso y esquema (copiables)
- Ejemplos aplicados
- Tabla comparativa: enfoques y herramientas
- Errores comunes → soluciones
- Limitaciones
- Escalado y gobernanza de prompts
- Preguntas frecuentes
- Puntos clave y siguiente paso
¿Qué falla en los agentes de IA y la automatización?
Los agentes de IA fallan cuando las salidas son ambiguas, el estado es implícito y las integraciones asumen respuestas ideales. En producción te enfrentas a tres modos recurrentes de fallo: deriva, no determinismo e integraciones frágiles.
La deriva ocurre cuando las indicaciones cambian o se pierde el contexto. El no determinismo es el comportamiento natural de los LLM probabilísticos. Las integraciones frágiles aparecen cuando un sistema downstream espera un esquema preciso pero recibe texto libre.
Ejemplo concreto: el agente de logística devolvía una “estimación de coste” en prosa. El sistema de pagos requería un campo numérico. La discrepancia creó una intervención humana que anuló las ganancias de la automatización.
Hechos declarativos cortos para citar:
- OpenAI documenta los tipos de mensajes system, user y assistant para controlar el comportamiento (OpenAI API docs, 2024).
- Anthropic recomienda limitar el razonamiento no estructurado en cadena para automatizaciones críticas por seguridad (Anthropic docs, 2023).
- n8n y orquestadores similares proporcionan nodos nativos y webhooks para envolver llamadas a LLM en primitivas de reintento y manejo de errores (n8n docs, 2024).
Marco: rol → contexto → tarea → estado
Responde primero: diseñas agentes componiendo cuatro capas. Cada capa es explícita y testeable. Las capas son rol, contexto, tarea y estado.
El rol define la persona del asistente y guardrail rígidos. El contexto aporta hechos y documentos relevantes. La tarea es la única acción medible que el agente debe devolver. El estado es el dato mínimo y explícito que el flujo almacena entre pasos.
Esto significa que nunca confías en que el modelo recuerde detalles efímeros. En su lugar, los persistes en un objeto de estado y pasas solo la porción relevante de vuelta al modelo.
Rol: bloquea el comportamiento del asistente
El rol es una instrucción de sistema corta que establece límites y tono. Mantenlo de 1–3 frases y evita lenguaje ambiguo.
Rol: Sistema
Contexto: Eres un asistente de procesamiento de facturas que extrae campos de facturación.
Tarea: Devuelve un objeto JSON validado con invoice_number, due_date, amount_usd.
Restricciones:
- No incluyas comentarios adicionales.
- Si falta un campo, ponlo en null.
Formato de salida: JSON conforme al esquema proporcionado abajo.
Anotación: El rol de sistema elimina respuestas en libre formato y dirige al modelo a adherirse a un esquema. Validado en GPT-4, observado junio de 2024.
Contexto: da solo los hechos necesarios
El contexto incluye mensajes recientes, documentos relevantes y un fragmento corto de memoria. Mantén el contexto dentro de la ventana del modelo y filtra previamente datos irrelevantes.
Contexto: Últimos 3 mensajes y el texto OCR de la factura:
- OCR: "[OCR_TEXT]"
- Fecha de la factura: [INVOICE_DATE] si está presente
- Mapeo de alias de proveedor conocido: { "ACME Inc": "ACME, Inc." }
Anotación: Limita el contexto a 200–800 tokens cuando sea posible para reducir ruido. Marcado por modelo: validado en Claude Opus (Anthropic), mayo de 2024.
Tarea: define una salida medible
La tarea debe ser una sola acción: extraer, clasificar o generar. Si necesitas múltiples acciones, encájalas en pasos secuenciales con estado explícito entre ellos.
Tarea: Extraer campos del OCR y devolver:
{
  "invoice_number":"[STRING|null]",
  "due_date":"YYYY-MM-DD|null",
  "amount_usd": [NUMBER|null]
}
Anotación: Las tareas de salida única facilitan el manejo de errores y los reintentos. Validado en GPT-4, observado junio de 2024.
Estado: explícito, versionado, idempotente
El estado es la única fuente de verdad para el agente. Almacénalo como un documento JSON con versionado de esquema y un id de operación. Eso permite idempotencia y reintentos seguros.
Esquema de estado (v1):
{
  "id": "[OPERATION_ID]",
  "schema_version": "1",
  "invoice": { ... },
  "attempts": 0,
  "status": "pending|success|failed",
  "last_error": null
}
Anotación: Versiona el estado para que puedas cambiar la indicación sin corromper flujos en ejecución. Observamos deriva de estado cuando los equipos no versionaban el esquema.
Indicaciones paso a paso y esquema (copiables)
Responde primero: usa una canalización de tres pasos: (1) sanitizar y extraer, (2) validar y normalizar, (3) confirmar y actuar. Cada paso tiene un bloque de indicación, restricciones y salida en esquema JSON.
Paso 1 — Sanitizar y extraer
Rol: Sistema
Contexto: Texto OCR: "[OCR_TEXT]"
Tarea: Extraer campos en bruto: invoice_number, date_raw, amount_raw.
Restricciones:
- Devuelve solo JSON.
Formato de salida:
{
  "invoice_number":"[STRING|null]",
  "date_raw":"[STRING|null]",
  "amount_raw":"[STRING|null]"
}
Anotación: Este paso aísla un OCR poco fiable. Marcado por modelo: GPT-4, junio de 2024.
Paso 2 — Validar y normalizar
Rol: Sistema
Contexto: Resultado de extracción en bruto del Paso 1.
Tarea: Parsear date_raw y amount_raw a campos normalizados o null si son inválidos.
Restricciones:
- Valida la fecha en YYYY-MM-DD.
- Convierte el importe a un número en USD (usa el mapeo de moneda del proveedor si se proporciona).
Formato de salida:
{
  "invoice_number":"[STRING|null]",
  "due_date":"YYYY-MM-DD|null",
  "amount_usd":[NUMBER|null],
  "validation_errors":[STRING...]
}
Anotación: Rechaza o marca valores ambiguos en vez de adivinar. Marcado por modelo: GPT-4, junio de 2024.
Paso 3 — Confirmar y actuar (o reintentar)
Rol: Sistema
Contexto: Objeto de factura normalizado, estado con contador de intentos.
Tarea: Si validation_errors está vacío, devolver "commit": true y los cambios de estado. De lo contrario, devolver "commit": false y una acción: "retry|escalate|human".
Restricciones:
- Idempotente: incluir id de operación en cada respuesta.
Formato de salida:
{
  "commit": true|false,
  "action":"retry|escalate|human",
  "state_update": { ... }
}
Anotación: Este paso decide si el workflow escribe en el ledger o pausa para revisión humana. Marcado por modelo: GPT-4, junio de 2024.
Ejemplos aplicados
Responde primero: dos escenarios concretos — un agente interno usando un LLM dentro de n8n, y una orquestación multiagente para atención al cliente.
Ejemplo 1 — Automatización AI en n8n para ingestión de facturas
En n8n, implementa tres nodos del workflow: webhook HTTP → Ejecutar indicación LLM (Paso 1) → Nodo Function para persistir estado → Repetir Pasos 2–3 con nodo de reintento. Usa el motor de workflow para reintentos y un nodo de base de datos para el estado.
Por qué funciona: n8n te da visibilidad y semánticas de reintento nativas. Usa webhooks para desacoplar el sistema externo del agente.
Ejemplo 2 — IA agentiva para triaje de clientes
Compón agentes pequeños: clasificar intención, resumir contexto, redactar respuesta. Cada agente devuelve JSON. Un orquestador enruta según el resultado de la clasificación. Para intenciones de alto riesgo, escala a humano con una instantánea del estado.
Observación: en Claude Opus observamos resúmenes más rápidos para contextos cortos; en GPT-4 obtuvimos salidas estructuradas más consistentes cuando el esquema se incluía primero como restricción del sistema (observación del Copy&Prompt TEAM, junio de 2024).
Tabla comparativa: enfoques y herramientas
| Enfoque | Fortaleza | Cuándo usar | Notas |
|---|---|---|---|
| Agente LLM-primero (modelo único) | Rápido para prototipar | Tareas de baja criticidad, prototipos | Requiere aplicar esquemas para ser fiable |
| Orquestador + nodos LLM (n8n, Airflow) | Observabilidad y reintentos | Automatización en producción con sistemas externos | Mejor para integraciones y controles operativos |
| Canalización multiagente/multi-modelo | Pasos especializados, modular | Flujos complejos, decisiones en varias etapas | Mayor coste de ingeniería; más robusto a escala |
Errores comunes → Por qué → Solución
Error 1 → Dejar las salidas en texto libre. Por qué: los sistemas downstream fallan al parsear. Solución: aplicar un esquema JSON en el límite del modelo y validar antes de confirmar.
Error 2 → Confiar en memoria implícita. Por qué: deriva de las indicaciones y saturación de la ventana de contexto. Solución: persistir el estado requerido y pasar solo lo que importa.
Error 3 → No usar claves de idempotencia. Por qué: los reintentos producen duplicados. Solución: incluir operation_id en el estado y hacer commits idempotentes.
Limitaciones: lo que esto no resuelve
Responde primero: este método reduce la fragilidad pero no elimina las alucinaciones del modelo, ni reemplaza reglas de validación de dominio.
Los LLM aún pueden alucinar valores numéricos o inventar nombres de proveedores. Los dominios de alta garantía (legal, médico) requieren validación tradicional y diseño con humano-en-el-bucle. Además, la latencia y el coste siguen siendo restricciones cuando llamas a modelos grandes por evento.
Escalado: almacenar, versionar, compartir
Responde primero: escala tratando las indicaciones como código: versionadas, revisadas y recuperables. Usa una biblioteca de prompts y adjunta metadatos (modelo, fecha de validación, versión del esquema).
Reglas prácticas:
- Almacena las indicaciones con un nombre semántico y una etiqueta de versión.
- Incluye el modelo y la fecha en que validaste la indicación.
- Automatiza pruebas de humo en despliegues: ejecuta entradas de ejemplo y asegura la conformidad del esquema.
Copy&Prompt es una biblioteca de prompts que te permite optimizar, almacenar, compartir y copiar indicaciones con un clic entre ChatGPT, Claude, Gemini, DeepSeek, Lovable y Midjourney.
Rol de Copy&Prompt
El equipo de Copy&Prompt usa el producto para mantener indicaciones y sus tests de validación en un mismo lugar. Puedes adjuntar tests de esquema, etiquetar indicaciones por modelo objetivo y compartir la indicación canónica con ingenieros y no ingenieros. Esto facilita rollbacks y auditorías.
Cómo verificar que tu agente funciona
Responde primero: ejecuta tres comprobaciones: conformidad de esquema, idempotencia y comportamiento en modo degradado.
- Conformidad de esquema: ejecuta 50 entradas de muestra y asegúrate de que el JSON cumpla al 100% para los commits.
- Idempotencia: vuelve a ejecutar la misma operation id; confirma que no hay efectos secundarios duplicados.
- Modo degradado: simula un error de modelo y asegura que el workflow escala o que la cola persiste.
Qué hacer si falla
Responde primero: reproducir, aislar, revertir la versión de la indicación y escalar en coincidencias persistentes.
Pasos:
- Reproducir el evento fallido en un sandbox con logs y comprobaciones de esquema.
- Si las salidas varían, fija la temperatura del modelo a 0 o cambia a modo determinista.
- Revertir a la última versión validada de la indicación en tu biblioteca de prompts.
Preguntas frecuentes
¿Cuál es la mejor forma de garantizar salidas estructuradas de un LLM?
Exige que el modelo devuelva JSON y valídalo contra un JSON Schema antes de cualquier acción downstream. Si la validación falla, devuelve un canal de error y enruta a revisión humana. Usa indicaciones basadas en esquemas y un rol de sistema estricto.
¿Cómo manejo reintentos sin crear duplicados?
Incluye un operation_id en el estado, persiste el contador de intentos y haz la escritura final idempotente. El workflow debe comprobar si operation_id ya fue confirmado antes de aplicar cambios.
¿Cuándo debería usar un orquestador como n8n vs un coordinador personalizado?
Usa n8n o similar cuando necesites muchos conectores nativos y velocidad de desarrollo. Construye un coordinador personalizado cuando necesites control fino, baja latencia o enrutamiento y observabilidad avanzados no disponibles en herramientas comerciales.
¿Con qué frecuencia debo revalidar las indicaciones ante nuevas versiones de modelos?
Revalida siempre que cambies de modelo o el proveedor actualice la familia de modelos. Como regla, ejecuta pruebas de sanidad por cada actualización del modelo y añade una fecha de validación a los metadatos de la indicación.
¿Cuál es un valor por defecto seguro para la temperatura del LLM en workflows de producción?
Configura la temperatura a 0 para salidas estructuradas deterministas. Usa temperaturas más altas solo para tareas creativas o exploratorias y aisla esas tareas de los workflows transaccionales.
Puntos clave
- Diseña agentes con cuatro capas explícitas: rol, contexto, tarea y estado.
- Aplica esquemas JSON en el límite del modelo y valida antes de confirmar.
- Persiste estado versionado e ids de operación para habilitar idempotencia y reintentos.
- Usa orquestadores para visibilidad; usa bibliotecas de prompts para gobernanza.
- Prueba las indicaciones en el modelo objetivo y registra las fechas de validación en los metadatos.
Siguiente paso: elige un flujo de producción que controles hoy y convierte sus suposiciones implícitas en un modelo de estado explícito y un esquema JSON. Ejecuta la canalización localmente con 50 muestras antes de desplegar.
Una vez que tengas quince prompts que realmente funcionen, el problema cambia: ya no es la calidad, es la recuperación. Mejora tus resultados de IA hoy — Crea mejores prompts y obtén respuestas más precisas con Copy&Prompt. Copy&Prompt →

